1. 执行摘要:在"混乱现实"与"完美代码"之间
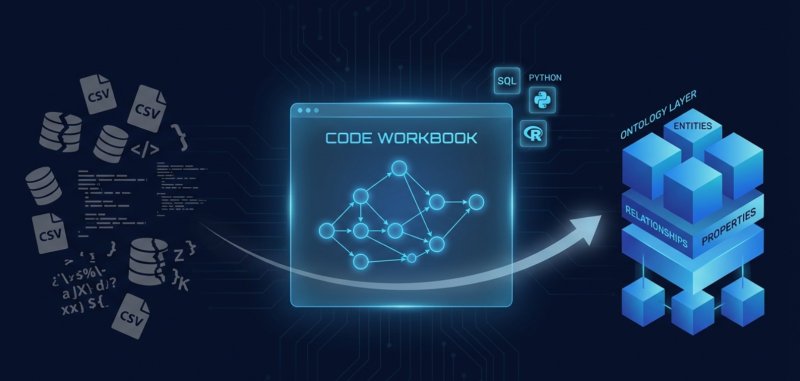
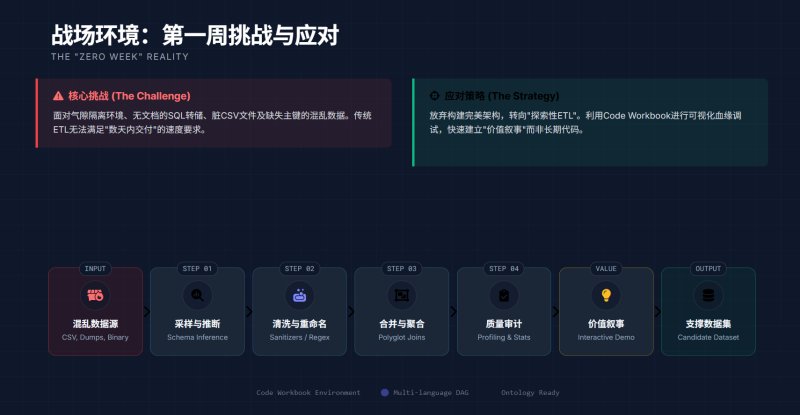
前向部署工程师(Forward Deployed Engineer, FDE)的角色,本质上是处于企业理想架构与现场数据"混乱现实"之间的突击队员。在项目进场的第一周——通常被称为"Zero Week"或"Discovery Phase"——FDE 面临的核心挑战并非缺乏算力,而是缺乏秩序。他们面对的是气隙隔离的服务器、无文档的遗留 SQL 转储、编码混乱的 CSV 文件以及逻辑晦涩的主机二进制数据。
在这种高压环境下,FDE 的首要任务不是构建完美的长期软件架构,而是建立"价值叙事(Value Narrative)"。这意味着必须在数天而非数月内,将支离破碎的数据转化为连贯、可交互的语义模型——即 Palantir 的核心技术壁垒:Ontology(本体层)。为了实现这一极速转化,FDE 依赖一套高度特化的"工具箱(The Toolkit)"。
本文将对这套工具箱进行详尽的技术解构。其核心是 Code Workbook,一个支持多语言混合编程(Polyglot)的交互式开发环境(IDE),它充当了数据集成的战术集结地。与强制线性流程的传统 ETL 工具不同,Code Workbook 允许 FDE 在同一个有向无环图(DAG)中无缝融合 SQL、Python 和 R。这种架构设计使得 FDE 能够同时利用 SQL 处理海量集合运算的优势、Python 处理复杂逻辑清洗与架构推断的灵活性,以及 R 语言在统计分析与可视化方面的专长。
我们将深入剖析 FDE 在实战中部署的具体"脚本"与架构模式,从用于字符串标准化的 Global Code 库,到用于即时质量保证的 Data Expectations。此外,报告将详述数据从原始形态转化为 Ontology 的全过程,包括"支撑数据集(Backing Datasets)"的构建、对象映射机制,以及保护本体层免受数据污染的严格"健康检查(Health Checks)"。最后,我们将探讨 AIP(人工智能平台)与大语言模型(LLMs)如何通过自动生成样板代码,正在根本性地重塑 FDE 的单兵作战模式。
2. 战场环境:前向部署的"第一周"现实
要理解 FDE 工具箱的技术特殊性,首先必须理解"第一周"的作战环境约束。FDE 并非进入一个拥有完善 API 文档和清晰数据模式的无菌环境,而是进入一个充满敌意的遗留系统丛林。
2.1 跨越技术鸿沟
FDE 的核心使命是跨越"The Delta"——即平台理论能力与客户数据实际状态之间的鸿沟。在这种背景下,标准的软件工程最佳实践(如广泛的单元测试框架、刚性的 CI/CD 流水线、微服务架构)往往需要暂时让位于 "速度致胜(Speed-to-Value)" 原则。目标不是编写可维护十年的代码,而是为了证明平台能够解决一个特定的、高价值的运营问题(例如:"呼吸机到底在哪里?"或"哪台喷气发动机需要维护?")。
2.2 战术集结地的战略地位
在这种高压环境下,Code Workbook 成为了默认的"战术集结地"。虽然 Foundry 平台提供了用于长期生产流水线的 Code Repositories(基于 Git 的结构化仓库)和面向非技术人员的 Pipeline Builder(低代码工具),但它们都无法满足"第一周"所需的探索性与速度。Code Workbook 允许快速迭代,提供即时的视觉反馈循环,数据可以实时摄入、可视化和转换。这使得 FDE 能够执行"探索性 ETL"——在理解数据形状的同时,将其扭曲成 Ontology 所需的格式。
2.3 工具箱的构成
所谓的"工具箱",并非单一的软件可执行文件,而是 FDE 社区在无数次实战中沉淀下来的一套方法论、架构模式和可复用的代码片段(Snippet)。这些通常存储在 FDE 个人的知识库或内部 Wiki 中,包括:
摄入加速器(Ingestion Accelerators):用于解析通用 CSV/Excel 结构并自动推断 Schema 的 Python 脚本。
卫生强制(Hygiene Enforcement):预构建的"Data Expectations",用于立即标记空主键或无效时间戳。
多语言转换逻辑(Polyglot Transformation):混合使用 SQL 进行重型数据搬运和 Python 进行精细解析的模板。
本体构造器(Ontology Constructors):将数据集格式化为"Object-Ready"支撑数据源的标准化逻辑。
3. 核心引擎:Code Workbook 的技术架构与多语言协同
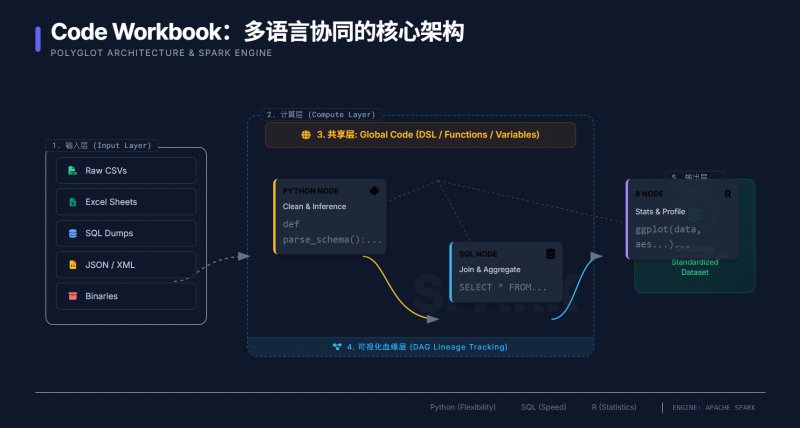
FDE 高效单兵作战的技术基石是 Code Workbook。这是一个基于浏览器的 IDE,它构建在分布式计算引擎 Spark 之上,但通过精巧的 UI 抽象了底层集群管理的复杂性,使得 FDE 可以专注于数据逻辑本身。
3.1 多语言 DAG 的战术优势
Code Workbook 的决定性特征是其在同一个数据流图中支持 Python、R 和 SQL 节点。这种"多语言(Polyglot)"能力不仅是为了方便,它是处理异构数据挑战的战略资产。
下表详细对比了三种语言在 FDE"第一周"工作流中的具体分工与优势:
| 语言环境 | "第一周"核心用例 | 战术优势与技术支撑 |
|---|---|---|
| SQL | 聚合与连接(Aggregation & Joining):快速连接孤立的表(如 SELECT * FROM table_a JOIN table_b)并过滤海量数据集 | 对于大多数分析师而言是原生语言;在 Spark 优化器(Catalyst Optimizer)下执行集合运算效率最高;代码极其紧凑,易于业务人员审查 |
| Python | 清洗与推断(Cleaning & Inference):利用 Regex 解析脏字符串,处理嵌套 JSON/XML,架构推断,以及编写命令式逻辑 | 访问庞大的库生态系统(Pandas, NumPy, PySpark API);处理非结构化数据和复杂字符串操作的唯一选择 |
| R | 剖析与统计(Profiling & Statistics):生成分布图,识别离群值,执行初步统计验证 | 拥有卓越的可视化库(ggplot2)和统计库,适合深度数据审计,能快速发现"沉默的数据故障" |
在典型的第一周工作流中,FDE 可能会首先使用 Python 节点来摄入并解析一个包含数百个 CSV 文件的文件夹,从文件名中提取元数据(如日期、地区)。这个 Python 节点的输出随后被传递给一个 SQL 节点,用于与传统的参考表(Reference Table)进行连接。最后,一个 R 节点可能会挂载在 SQL 输出之后,用于可视化数值分布,确保在数据进入 Ontology 之前质量达标。
3.2 Spark 后端与可视化的数据血缘
在底层,Code Workbook 的每一次转换(Transform)实际上都是提交给 Spark 集群的一个作业(Job)。然而,UI 将这些作业可视化为依赖图。这种可视化的血缘关系在探索阶段至关重要。当 FDE 在最终数据集中发现一个"坏"值时,他们可以通过视觉回溯 DAG 图,精确定位是哪一个转换步骤或哪一个源文件引入了错误。相比于扫描传统的代码仓库文件或运维日志,这种"视觉调试"能力显著降低了数据问题的平均修复时间(MTTR)。
3.3 Global Code 面板:构建领域特定语言
Code Workbook 中一个隐蔽但极其关键的功能是 Global Code 面板。
定义与功能:这是一个共享的代码空间,允许 FDE 定义变量、函数和类,这些定义对 Workbook 中的所有节点可见。
战术价值:FDE 利用此功能为特定项目构建"领域特定语言"(DSL)。例如,如果客户有 50 个不同文件使用了同一种专有的日期格式,FDE 可以在 Global Code 中编写一个单一的 parse_client_date(date_str) 函数。
效率倍增:之后,每一个 Python 节点只需简单调用 parse_client_date() 即可。这不仅确保了逻辑的一致性,还模仿了软件工程中的"库(Library)"概念,但在 Workbook 的快速原型环境中更加轻量级。
4. 实战脚本库:数据清洗与转换的"标准动作"
当 FDE 在第一周打开他们的工具箱时,他们实际上是在应用一系列特定的代码模式。这些模式利用了 PySpark API 的强大功能和 Workbook 环境的灵活性,旨在迅速中和原始数据的混乱。
4.1 自动化架构推断
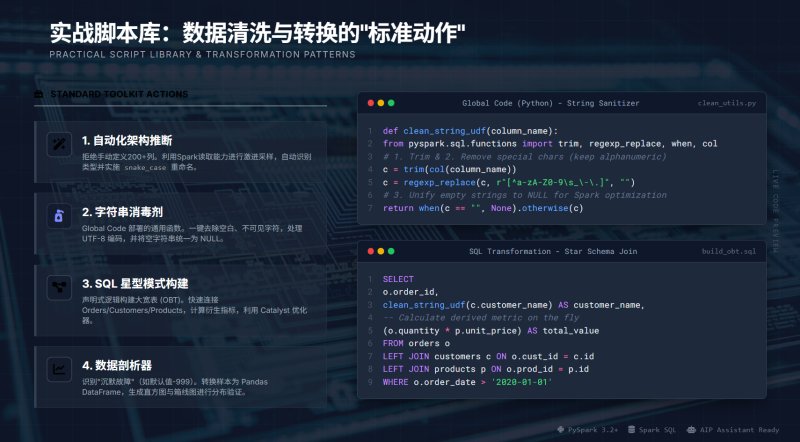
数据工程中最耗时的任务之一是为成百上千个列定义 Schema。在第一周,FDE 绝不会手动编写这些定义。他们使用 Python 脚本利用 Spark 的"读取"能力进行自动化推断。
脚本逻辑解析:
FDE 不会手动输入 StructType()。相反,他们使用带有激进采样策略的 Spark 读取命令。
采样读取:脚本读取 CSV 或 JSON 数据的一个子集(Sample)。
模式识别:遍历所有列,检查常见模式(例如,"这一列看起来像时间戳吗?""全是数字吗?")。
标准化重命名:自动将列名转换为"snake_case"(小写加下划线),以符合 Foundry 数据库对列名的严格要求(不喜空格和特殊字符)。
战略意义:这使得 FDE 能够在几分钟内摄入一个包含 200 列的遗留 ERP 导出文件,而不是耗费数小时进行手动定义,从而立即生成可供探索的数据集。
4.2 字符串消毒剂
遗留数据中充斥着肉眼不可见的空白字符、不间断空格(Non-breaking spaces)和编码伪影。FDE 的标准工具箱包含一个通过 Global Code 部署的综合字符串清洗函数。
核心逻辑(Python 概念代码):
Copy# Global Code 定义
def clean_string_udf(column_name):
    from pyspark.sql.functions import trim, lower, regexp_replace, when, col
    # 1. 去除首尾空白
    c = trim(col(column_name))
    # 2. 移除特殊字符(保留字母数字和基本标点)
    c = regexp_replace(c, r"[^a-zA-Z0-9\s_\-\.]", "")
    # 3. 统一空字符串为 NULL(这对 Spark 优化至关重要)
    c = when(c == "", None).otherwise(c)
    # 4. 强制 UTF-8 兼容性处理(概念性)
    return c
在 Code Workbook 中,这个函数可以被批量应用于 DataFrame 中的所有字符串列。这确保了 Ontology 中的对象不会因为" London "和"London"的区别而产生重复,从源头消除了实体解析(Entity Resolution)的隐患。
4.3 SQL 星型模式构建器
数据清洗完毕后,FDE 必须对其进行建模。工具箱严重依赖 SQL 节点来快速构建星型模式(Star Schema)或大宽表(One Big Table, OBT)。
场景:客户提供 Orders(订单)、Customers(客户)和 Products(产品)作为独立的 CSV 文件。
SQL 节点实战:FDE 编写一个 SQL 转换,将这些表连接成一个 Denormalized_Orders 数据集。
CopySELECT
    o.order_id,
    c.customer_name,
    p.product_sku,
    o.order_date,
    -- 快速计算衍生指标
    (o.quantity * p.unit_price) as total_value
FROM orders o
LEFT JOIN customers c ON o.cust_id = c.id
LEFT JOIN products p ON o.prod_id = p.id
WHERE o.order_date > '2020-01-01' -- 过滤掉太旧的数据以加速迭代速度优势:在此处首选 SQL 是因为它是声明式的。FDE 只需描述想要什么,Spark 的优化器负责处理执行计划。在初步探索阶段,这比编写复杂的 PySpark 连接链要快得多,且更易于调试。
4.4 数据剖析器
在将数据集提升(Promote)到 Ontology 之前,FDE 必须验证其内容分布。利用 Code Workbook 的"模板"或自定义绘图代码,FDE 生成直方图和箱线图。
脚本逻辑:一个 Python 节点将 Spark DataFrame 的样本转换为 Pandas DataFrame(使用 .toPandas()),然后调用 matplotlib 或 seaborn 库。
洞察发现:这一步能揭示"沉默的故障",例如某个传感器读数在离线时默认为 -999,或者某个日期列的所有值都是 1970-01-01。在这里捕获这些问题,可以防止在 Ontology 中创建数百万个垃圾对象。
5. 语义飞跃:从 Code Workbook 到 Ontology
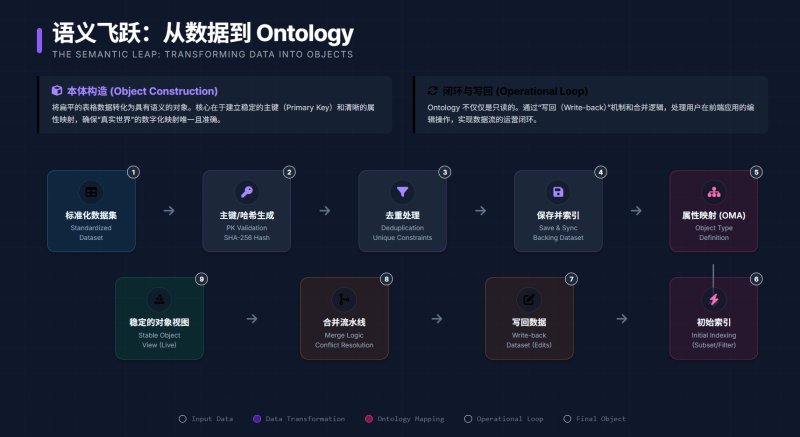
FDE 在第一周的终极目标不仅仅是一个干净的数据集,而是一个功能性的 Ontology(本体)。Ontology 是 Foundry 的语义层,它将数据映射为现实世界的概念(对象、属性、链接和动作)。从 Code Workbook 到 Ontology 的过渡涉及一系列特定的技术步骤和工具箱配置。
5.1 支撑数据集的概念
Ontology 中的对象类型(例如 Employee)是由 Foundry 中的特定数据集"支撑(Backed)"的。
核心要求:支撑数据集必须拥有一个指定的主键(Primary Key)列,该列对于每一行必须是唯一的。
工具箱动作:FDE 使用特定的转换模式来确保这种唯一性。
去重:df.dropDuplicates(['employee_id'])
键生成(Key Generation):如果不存在自然键,FDE 会生成一个基于复合列的确定性哈希值(例如 sha256(concat(col_a, col_b)))作为主键。
警告:FDE 严禁使用随机 ID 生成(如 UUID()),因为这会导致每次构建都生成新的 ID,从而破坏对象历史记录和链接关系。
5.2 物化与索引
一旦支撑数据集在 Code Workbook 中准备好并保存,它必须被"索引"到 Ontology 的存储层(Phonograph / Object Storage v2)。
操作流程:FDE 导航至 Ontology Management App (OMA),选择"Create Object Type",并将其指向 Code Workbook 的输出数据集。
属性映射:数据集的列被映射为对象的属性。
- emp_id (数据集列) -> Employee ID (对象属性,主键)
- start_date (数据集列) -> Hire Date (对象属性,日期类型)
状态监控:FDE 会密切监控"索引"状态。如果支撑数据集过于庞大,他们可能会先在 Code Workbook 中进行过滤(例如"仅包含在职员工"),以加速初始索引过程,使应用程序更快上线。
5.3 处理"写回"与编辑闭环
FDE 价值主张的一个关键部分是启用 Action——允许用户编辑数据。Ontology 通过"写回"机制处理此问题。
闭环逻辑:
- 用户在 Foundry 应用程序(如 Workshop)中编辑对象。
- 编辑内容被存储在一个"写回数据集(Write-Back Dataset)"中。
工具箱脚本:FDE 创建一个"合并(Merge)"流水线。此脚本读取原始源数据,并将其与"写回数据集"合并,以生成世界的当前状态。
这个合并后的视图成为新的支撑数据集,从而闭合循环。
复杂性管理:正确编写此合并逻辑对于防止数据丢失至关重要。FDE 使用标准模板来处理冲突解决(例如,"用户编辑优先于源更新")。
6. 质量保证:安全网脚本
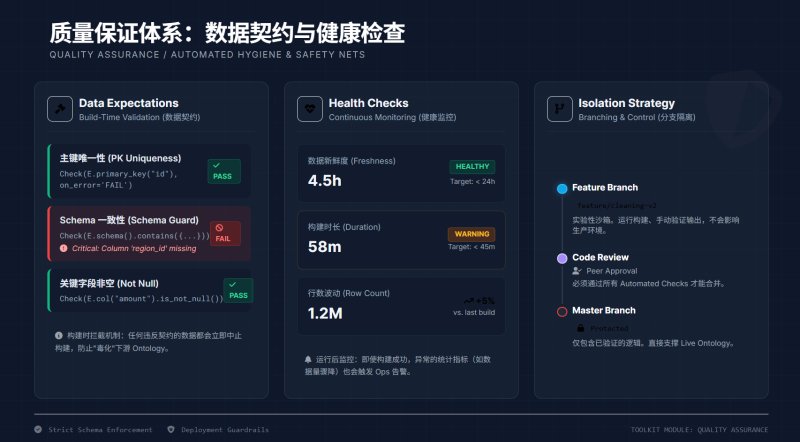
在 FDE 的工作中,速度是把双刃剑。为了防止"速度致胜"变成"速度致败",FDE 工具箱包含严格的自动化检查。这些通常直接在 Code Workbook 或 Repository 中使用 transforms.expectations 库实现。
6.1 Data Expectations(数据契约)
Data Expectations 允许 FDE 为数据定义一份"契约"。如果传入的数据违反了这份契约,构建将中止,从而防止污染 Ontology。
常用 Expectation 脚本模式:
主键验证:Check(E.primary_key("id"), "pk_check", on_error='FAIL')。这对于支撑数据集是不可协商的。如果存在重复,构建必须失败,否则 Ontology 索引将崩溃。
Schema 一致性:Check(E.schema().contains({...}), "schema_check")。这确保如果源系统静默删除了某一列,流水线会立即通知 FDE。
非空检查:Check(E.col("critical_value").is_not_null(), "null_check")。
6.2 健康检查
除了构建时的 Expectations,FDE 还会配置针对输出数据集的健康检查。
新鲜度(Freshness):"如果此数据集在 24 小时内未更新,请向我报警。"这对于运营仪表板至关重要,因为陈旧的数据可能导致错误的决策(例如,因为库存数据流卡住而显示"仓库已空")。
作业时长:"如果构建时间超过 1 小时,请报警。"这通常预示着性能退化或数据量突然激增。
6.3 分支与隔离
Code Workbook 支持 Git 风格的分支管理。
工作流:FDE 在 feature/new-cleaning-logic 分支上工作。他们运行构建,验证结果(使用可视化工具),然后合并到 master。
保护机制:这防止了实验性代码破坏客户正在查看的实时 Ontology。master 分支通常受到保护,要求在合并前进行审查或通过构建检查。
7. 高级工作流:工具选择与迁移路径
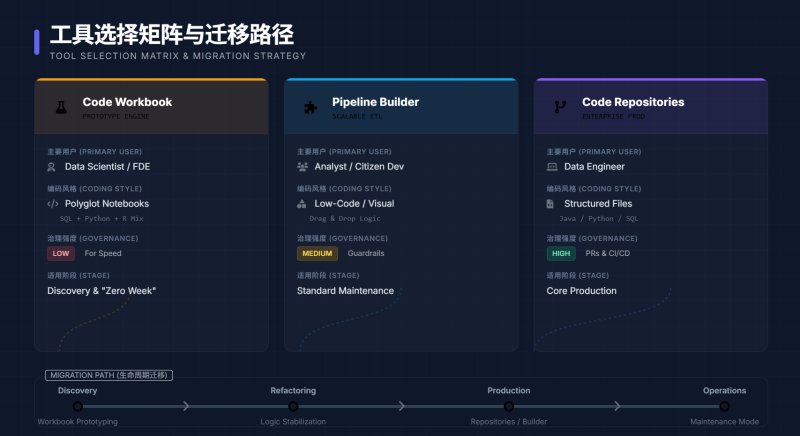
虽然 Code Workbook 是"第一周"的英雄,但 FDE 必须知道何时过渡到其他工具。工具箱的一部分智慧在于知道哪个工具适合生命周期的哪个阶段。
7.1 Authoring 工具对比分析
| 特性维度 | Code Workbook | Pipeline Builder | Code Repositories |
|---|---|---|---|
| 主要用户 | 数据科学家 / FDE (原型设计) | 业务分析师 / 公民开发者 | 数据工程师 (生产环境) |
| 编码风格 | 多语言 (SQL/Python/R) 单元格 | 低代码 / 无代码拖拽 | 结构化的 Python/Java/SQL 文件 |
| 治理强度 | 较低 (注重迭代速度) | 中等 (有护栏) | 高 (Pull Requests, 严格分支策略) |
| 适用阶段 | Discovery & "Zero Week" | 标准 ETL & 维护阶段 | 核心企业级流水线 |
7.2 迁移路径
FDE 的常见模式是:
在 Workbook 中原型化:使用 Python 和 SQL 单元格拼凑逻辑,打通数据流并构建 Ontology(第 1 周)。
在 Builder/Repositories 中固化:一旦逻辑稳定,将成功的转换逻辑"重构"到 Pipeline Builder(便于客户 IT 维护)或 Code Repositories(用于复杂、受治理的逻辑)。
归档 Workbook:Workbook 保留作为临时分析的"实验室",但生产数据流迁移到更稳定的环境。
8. 工具箱的未来:AIP 与自动化革命
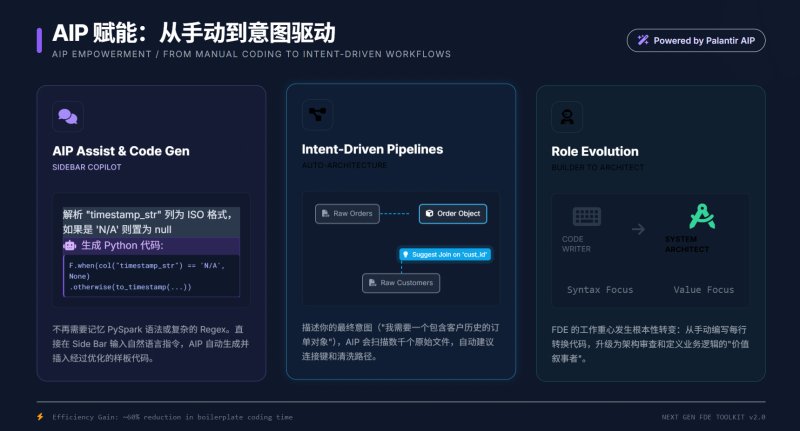
FDE 工具箱的定义目前正经历着由 Palantir AIP (Artificial Intelligence Platform) 引发的剧烈变革。手动编写清洗脚本正在被 AI 辅助生成所取代。
8.1 Code Workbook 中的 AIP Assist
AIP Assist 是直接集成在 Code Workbook 界面中的 LLM 驱动侧边栏。
新工作流:FDE 不再需要手动编写针对特定日期格式的 Regex,而是高亮显示该列并输入提示词:"将此列解析为 ISO 8601 格式,并处理 'N/A' 字符串。"
自动生成:AIP 生成相应的 Python/Pandas 代码块。
影响:这几乎将"语法查找"的时间降至为零。FDE 可以完全专注于逻辑和架构,而不是记忆特定的 PySpark 函数名称。
8.2 从手动到"意图驱动"的流水线
高级 AIP 功能允许基于"意图"创建流水线。FDE 可以描述所需的 Ontology 对象("我需要一个具有这些属性和维护历史的车辆对象"),AIP 能够扫描可用的原始数据集,建议必要的连接,甚至起草流水线逻辑。这标志着 FDE 的角色从单纯的"构建者(Builder)"转变为代码的"架构师"和"审查者"。
9. 结论
Palantir 前向部署工程师的工具箱是战术敏捷性与战略严谨性的结合体。它以 Code Workbook 为核心,利用 SQL、Python 和 R 的多语言能力来驯服"混乱的现实"。通过一系列标准化的清洗模式、架构推断脚本,以及 Data Expectations 实施的即时验证,FDE 能够迅速将原始混沌转化为结构化的支撑数据集。
这个数据集构成了 Ontology 的基础,即组织的数字孪生。FDE 的真正专长不仅在于编写代码,还在于编排这一转换过程——确保数据不仅在技术上是干净的,而且在语义上是有意义的,在运营上是弹性的。随着 AIP 的不断演进,"工具箱"正变得越来越智能,自动化了死板的清洗任务,从而释放 FDE 的精力,专注于定义项目成败的高价值"价值叙事"。
对于技术领导者而言,关键启示如下:
拥抱多语言工作流:不要强迫 FDE 只使用一种语言。Code Workbook 的力量在于融合 SQL 的速度与 Python 的灵活性。
重视血缘可视化:可视化的 DAG 对于调试遗留数据至关重要。
尽早强制主键:如果没有支撑数据集中的稳健主键逻辑,向 Ontology 的过渡注定失败。
即时验证:使用 Data Expectations 快速失败构建,防止"毒化"运营 Ontology。
规划迁移:Code Workbook 是为了速度;必须有计划将其迁移到 Repositories 或 Pipeline Builder 以实现长期稳定。