python -V
3.10
python -c "import torch; print(f'Torch: {torch.__version__}'); print(f'CUDA: {torch.version.cuda}')"
Torch: 2.7.0+cu126
CUDA: 12.6

python -c "import torch; print(f'GLIBCXX_USE_CXX11_ABI={torch._C._GLIBCXX_USE_CXX11_ABI}')"
GLIBCXX_USE_CXX11_ABI=True
根据检测到的环境信息:
- PyTorch 版本:
2.7.0+cu128(CUDA 12.8) - Python 版本:
3.10
需要下载的 flash-attn 版本为 2.7.4.post1。
1. 下载链接
请访问 Flash Attention GitHub Releases 页面:
https://github.com/Dao-AILab/flash-attention/releases/tag/v2.7.4.post1
2. 目标文件名
在该页面下的 Assets 列表中,请寻找符合以下命名规则的文件(对应 CUDA 12.8 和 Torch 2.7):
文件名预测:flash_attn-2.7.4.post1+cu128torch2.7cxx11abiTrue-cp310-cp310-linux_x86_64.whl
注意:如果找不到 cu128 的版本,可能是因为官方尚未发布针对 CUDA 12.8 的预编译包。在这种情况下,您可以尝试找 cu12x 系列最接近的版本,但如果不匹配可能会报错。如果必须用此版本且无预编译包,则只能选择源码编译(耗时较长)。
3. 安装方法
将下载好的 .whl 文件上传到服务器,然后运行:
pip install flash_attn-2.7.4.post1+cu128torch2.7cxx11abiTrue-cp310-cp310-linux_x86_64.whl4. 验证
安装完成后,可以用以下命令验证是否可用:
python -c "import flash_attn; print(flash_attn.__version__)"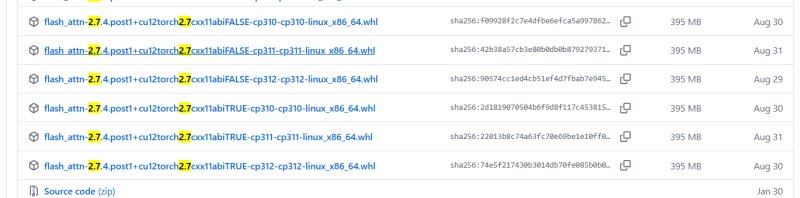
下载这个文件即可
flash_attn-2.7.4.post1+cu12torch2.7cxx11abiTRUE-cp310-cp310-linux_x86_64.whl