gpt-6-sol-low:轮子飞上去了!!
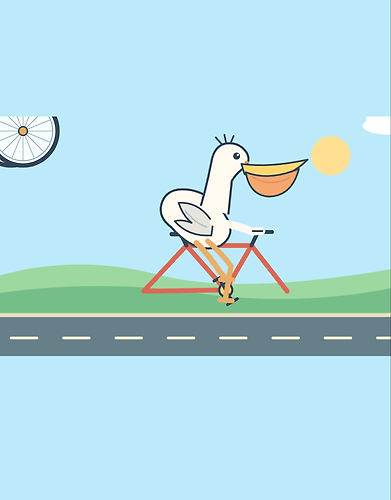
gpt-6-sol-max:小Astra!
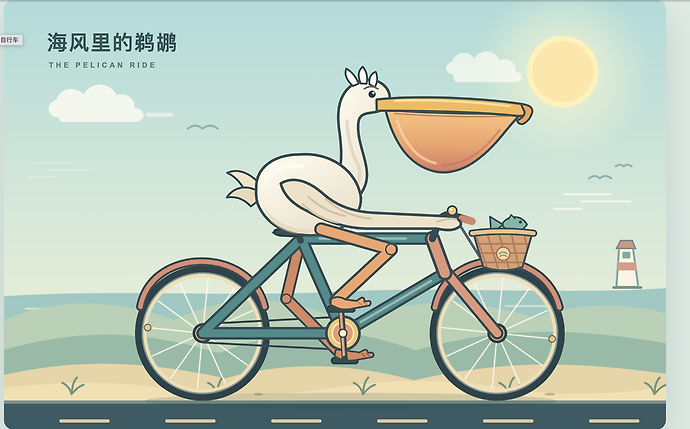
gpt-6-luna-max:也还可以
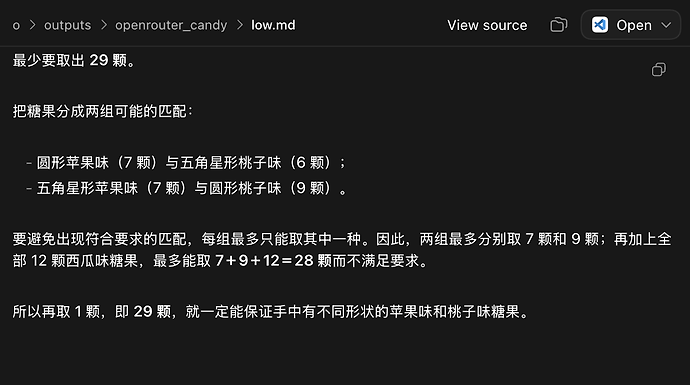
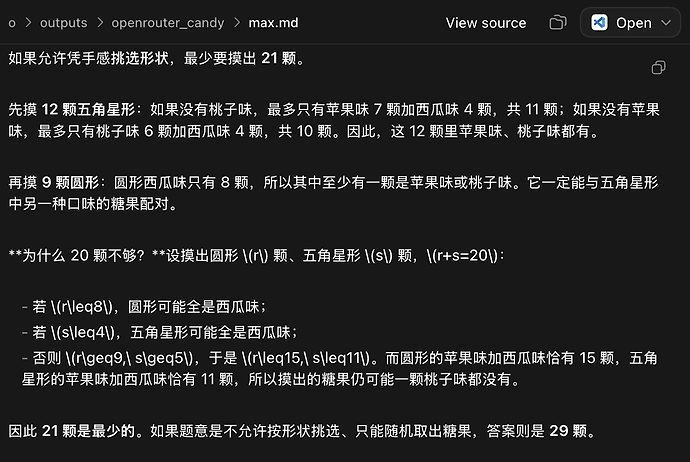
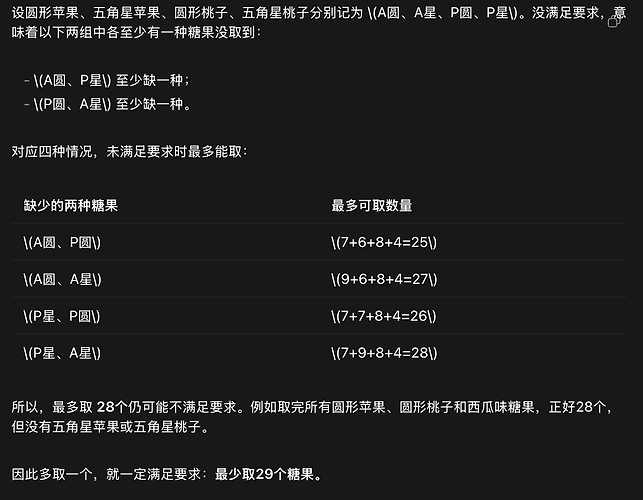
糖果题:
gpt-6-sol-low:29忽略手感
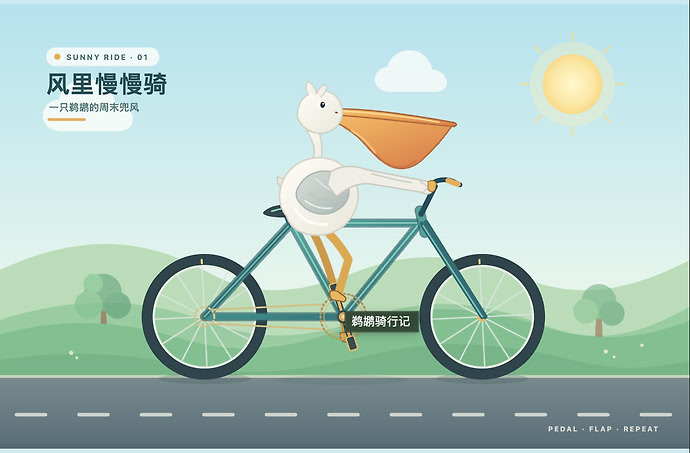
gpt-6-sol-max:21正确
gpt-6-luna-max:也是不对的
其实鹈鹕测试这种东西,因为大家codex提示词不同,记忆不同,LLM本质还是在空间采样,从输入条件下的输出分布中生成,有一些差异是正常的,除非非常离谱,不然难以通过鹈鹕判断降智,当然这个6-sol-low也确实离谱.
当然更准确的还是去sub2api或者cpa去看实际请求模型,上面只用Openrouter的api给大家作参考.
我手上有4个降智的号,我最近也一直在找攻克方案.手上唯一还正常的号上个帖子做的鹈鹕测试,6-sol-low的轮子也是飞的,有位佬友非常肯定这就是降智,靠鹈鹕测试看降智是不太靠谱的,Openrouter的key也这样,轮子飞起来,如果真的要判断大家还是去sub2api或者cpa去看实际请求模型,当然降智的话佬友工作的时候也能感觉出来.