什么是编排模式?
是我在Piwin(【开源推广】20个包, 70天,我的桌面端coding agent终于能见人了——piwin)中实现的一种多Agent实践。
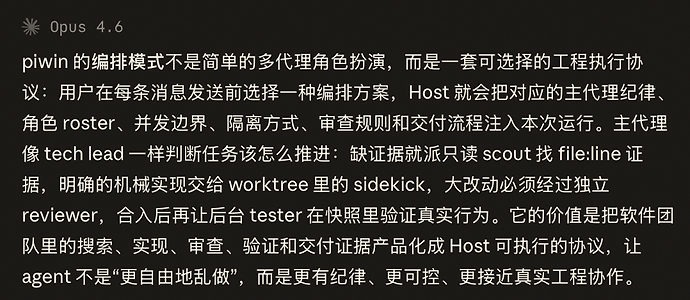
什么是Auto智能编排?
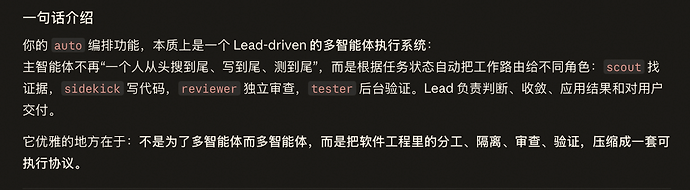
原先的ultra和fusion(具体可看我piwin推广帖子的单独介绍),单独拎出来确实太过于鸡肋了,简单说排查问题用ultra,写新功能用fusion太不负责了,于是我想着尽量结合二者,同时利用一些harness去优化模型工作;auto 的设计目标是提高开发的可控性,因为我们往往不能够提供足够准确的提示词,总是希望一句话模型就可以帮我们解决问题,所以让 Agent 在明确工程约束下执行可以提升agent决策的准确性。
搞了一些harness规则:
1.先输出「goal」,并按最少读取规则读、查;
为什么这样搞呢?
前者可以提醒我们模型意图识别是否准确,不对的话可以暂停进行信息补充(我觉得蛮有用的);后者是针对当前大部分模型存在思考过度、无意义重复乱读的问题,各家主流flash(gemini除外)、grok等基本上都有这个问题,尤其是提示词不准确的情况;
这条规则是我从佬友的帖子如何在DSH里提高DS4.1F的效率,根治多动症和发散行为。 - #21,来自 yorickjue 中的agent.md 中抄过来的,感兴趣的佬友可以看一下,我觉得写的十分贴切,是很有用的harness;
2.减少上下文污染、
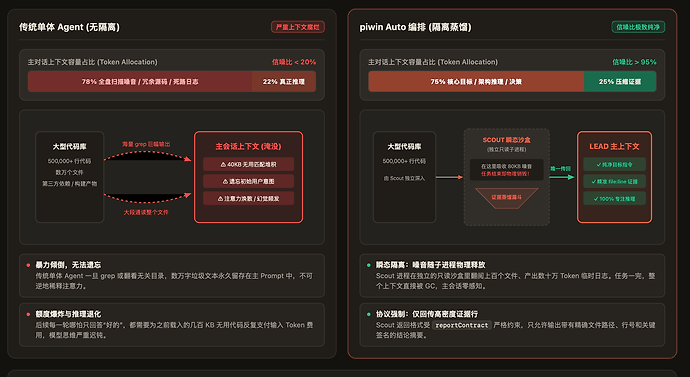
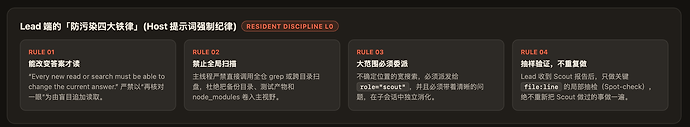
我在Piwin中定义了Code_search和Scout子代理两个功能都是为了减少上下文污染。上下文污染对于上下文决策及其重要 如果你看过模型的调用链路 你会发现 最常见的调用是Grep和Read 那些思考链路的模型有时候真不知道在干嘛 瞎几把读 是不是在偷我代码 那些查特娘一二十分钟不动手的在干嘛!!
上下文污染是我随便造的词,应该没专用词汇,子代理一开始诞生的目的,就是为了上下文隔离,explore 代码搜索/分析、Bash大量 shell output、工具调用输出,比如浏览器的screenshot,这些东西如果都塞在主代理里,会造成大量的上下文占用,如果用子代理,会总结输出给主代理节省大量上下文;
上下文有那么重要吗? 上下文决定模型决策!
我们最常见的长思考的模型(我觉得国产模型现在都在长思考,你们到底有没有蒸馏anthropic!)会读取目录树-》读取大量文件-〉读了好多无关实现(要拿来训练吗?)-》测试;这些东西都塞在同一个上下文,有用的,无用的,一起都读了,这造成了注意力被稀释,对注意力造成了极大的阻碍了;你读了30个文件,我实际只要修改4个文件,我4个文件要和剩下的26个相关文件竞争注意力,bro,fucking terrible .
错误线索残留: ds的 “等等,我发现…!”(不确定思维链是不是这样写,忘了),自我否定,重复查询,如果过程有一个旧实现,模型的决策会不会受到旧逻辑的影响?权重可能很小,但肯定会受到影响。fucking terrible .
推理状态混乱:会产生“可能是 A → 不对 → 可能是 B → 又排除”的中间假设,这个过程中产生了冗长的上下文,这些上下文有大量的废物信息,有用的信息占比很少,该死的很,这时候你主动compact一下效果会好很多,但是你不会,因为会话还在工作。
烧钱:特娘的,上面说的这些废物东西,你说你要不要缓存,缓存不收费还好,问题是大部分订阅缓存都收取费用,虽然少,但是也是钱,而且随着堆叠,越来越多,越来越大,请求带上好大一坨屎啊!A/不收钱还好,我直接opus5.5帮我全干了,但是我没那么多a/token
经过上面几层,上下文虽然没超(对啊,我足足有1000000上下文,你屎虽然多,但我还塞得下),但是我很难找到关键的决策信息,也就是说,“有效信息密度”下降,我100个橘子中只有一个好橘子,这也太为难我胖虎了!这也是我认为为什么codex和cursor默认都是256K上下文的原因之一,勤奋的compact应该能解决一部分问题。
然后!我上面逼逼赖赖那么多,上下文如果短一点应该能解决一点问题吧?实则不然,长上下文的好处其实大家都知道,我这里献丑一波:
codebase搜索的时候不会漏,现在主流的模型就是长思考的模型,你一二十分钟(平均,我见过搜索了半个多小时不干活的模型)的代码库检索真的会触发compact,代码都不知道哪些是关键的就触发了compact!
compaction是上下文管理中最重要的环节,没有之一,我们以pi的compaction进行讨论,每次保留一定的最近token,渐进式summary,summary必然是丢掉一些token,保留一些关键token,哪些是关键的?哪些是可弃的捏?如果上下文窗口很小,这就代表我们必须summary很多信息,丢弃很多信息,这就必然对模型决策造成极大的影响!窗口足够大,就可以保留更多原始 evidence,相对有效决策信息可以保留更多,对模型决策有益,然后额外提一嘴,anthropic曾说,他们家的模型能感知到上下文窗口,快满的时候,思考和决策会相对保守的多;
长上下文对于长任务来说也是必须的。我们很多时候会甩一个长上下文给模型,许愿让他帮我们处理好每一个细节,实现一个伟大的项目。所以对于完整读完长文档/长信息的能力是必须的;
多模态/多工具的需要:现在模型的能力越来越强,我们往往会引入各种各样的工具,工具的响应信息是我们决策信息的重要组成来源,工具很多,信息很多,很难得出哪些是重要信息,所以都保留着最好(这部分其实我也不确定,模型到底知不知道,哪些重不重要,以此compact),所以长上下文yes。
总之,长上下文很重要,而上下文污染问题也有待解决,所以子代理横空出世,往往都是为了解决长上下文污染(非专业术语,纯在自我娱乐)的问题,“scout”是解决上下文污染的一个解决办法,可以理解为“查询子代理+信息压缩器”可以解决我上面说的一大堆东西;
并非胡说
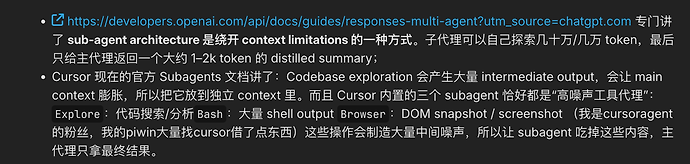
这个上下文污染也不是新东西了,今年年初就基本有定论了。
3.devin fusion
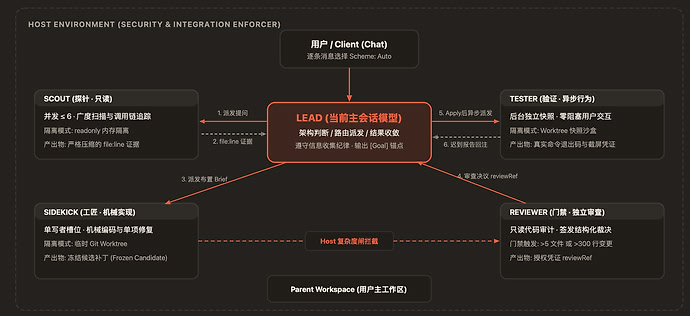
piwin偷了devin点东西,包括code_search(fast-search)、web_search还有这个devin fusion;auto中定义了不同角色:
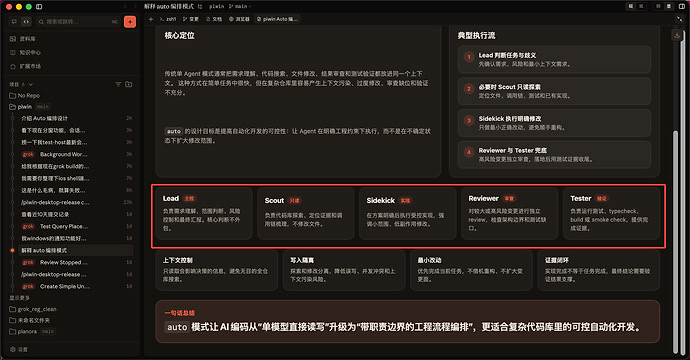
Lead主导规划,搞个sota模型配个sidekick执行模型,比传统的主模型主导一切,更便宜(并非省token);(Lead fable5.1,Scout swe1.6/gemini3.6flash(快就完了),sidekick(flash/grok),reviewer(luna),tester(考虑到可能会e2e可以配个agentic能力强的模型);
4.other
sidekick是独立的worktree单并发进行coding的,原因是devin进行了数据测试,有据可依:
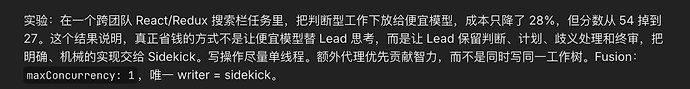
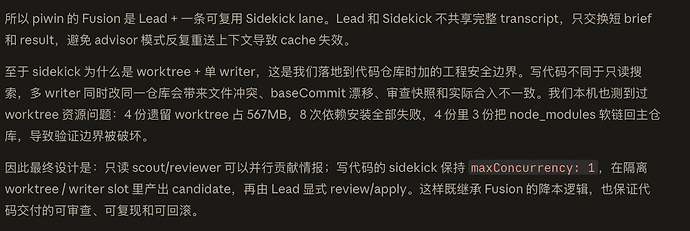
tester不阻塞用户反馈,长测试时独立worktree运行,好好好啊。
一句话:

这样设计不烧心。都是东拼西凑的实现,欢迎佬友的批评建议与讨论